library(tidyverse) # Conjunto de pacotes e funções para realizar análise de dados no R
library(readxl) # Para fazer leitura e também exportar arquivos em formato Excel.
library(gt) # Para elaboração de tabela com qualidade publicação
library(here) # Para facilitar trabalhar com caminhos de pastas
library(fixest) # Pacote mais utilizado para dados em painel
library(skimr) # Pacote para ver um conjunto de estatística descritivas
library(sandwich) # vcovHC() para erros-padrão robustos
library(lmtest) # coeftest()Aula Prática - Dados em Painel
Introdução
Nas duas aulas práticas anteriores, trabalhamos com dados de corte transversal: na primeira, a variação no tratamento vinha de um experimento aleatório; na segunda, tentamos eliminar o viés de variável omitida controlando por características observáveis dos estudantes. O problema da segunda estratégia é evidente: sempre restam determinantes do resultado que não conseguimos observar e, portanto, não conseguimos incluir na regressão.
Dados em painel oferecem uma saída parcial para esse problema. Quando acompanhamos as mesmas unidades ao longo do tempo, podemos eliminar todos os fatores omitidos que são fixos no tempo dentro de cada unidade — mesmo aqueles que não observamos — comparando cada unidade com ela mesma. O objetivo da aula de hoje é implementar essa ideia no R, partindo do modelo mais simples (“antes e depois”) até o modelo de efeitos fixos duplos (two-way fixed effects).
Leituras de referência
Seções 10.1 a 10.7 de Stock e Watson. Introduction to econometrics. Slides das aulas 7 e 8.
Discussão
Impostos sobre bebidas alcoólicas reduzem mortes no trânsito? Antes de olhar para os dados, pense: por que uma simples regressão da taxa de fatalidade sobre o imposto estadual sobre a cerveja, usando dados de um único ano, provavelmente não recuperaria o efeito causal do imposto? Que características dos estados estariam no termo de erro? Quais delas mudam de um ano para o outro e quais são essencialmente fixas?
Descrição da atividade
A ideia para aula prática de hoje será reproduzir a Tabela 10.1 do livro de Stock e Watson reproduzida abaixo.
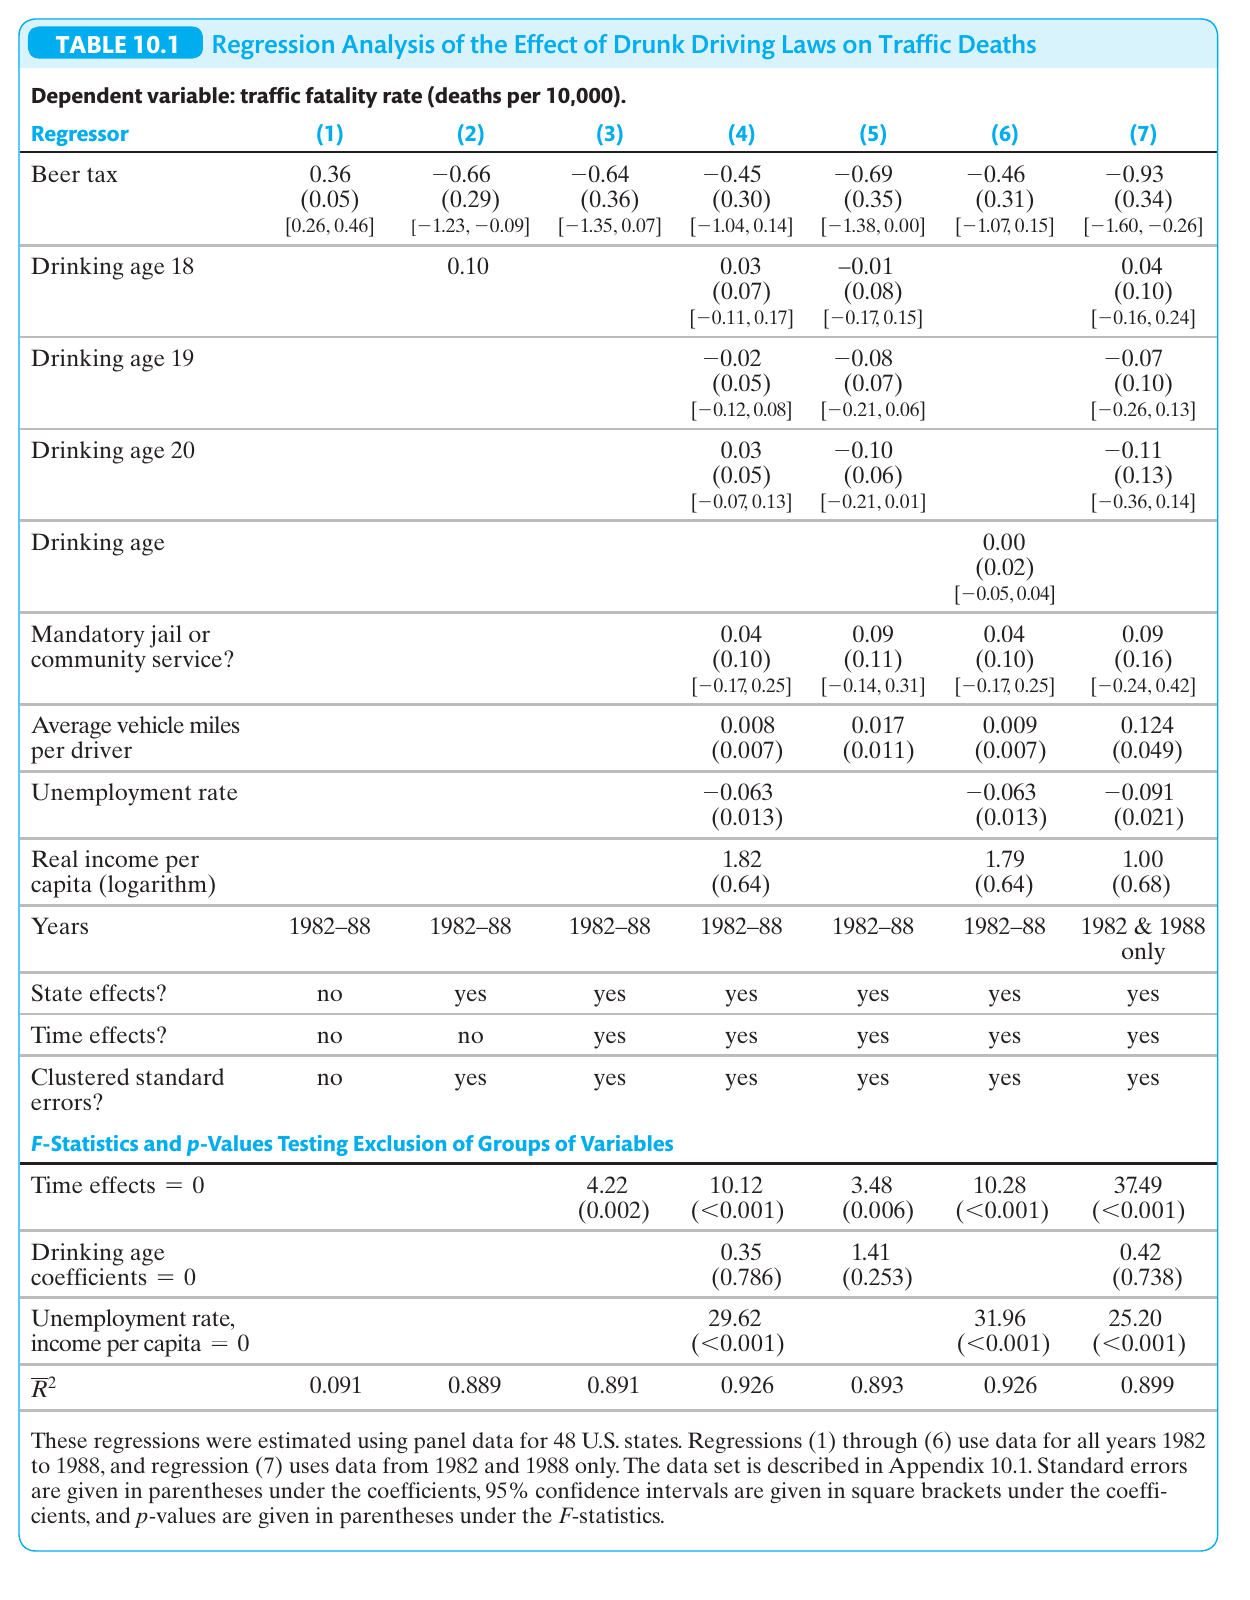
Observação: Na 1a edição do livro é a tabela 8.2.
- Fazer download da base de dados e do dicionário de variáveis. Importar dados para o R.
Antes de iniciar a atividade, vamos chamar os pacotes que serão utilizados. Nesta resolução são utilizados os seguintes pacotes do R.
Agora, vamos importar os dados e salvá-los no objeto chamado Fatality.
# Carregar os dados
# Ajuste o caminho conforme a localização do arquivo na sua máquina
Fatalities <- read_excel(here("labs","fatality.xlsx"))- Este painel é balanceado?
Um painel é balanceado quando todos os estados possuem o mesmo número de observações ao longo do tempo. Caso contrário, o painel é não balanceado, o que pode ocorrer por dados faltantes para algum estado em determinado ano. Como vemos abaixo, há 48 estados na base de dados e, para cada estado, o número mínimo e o número máximo de observações são iguais a 7 (os anos de 1982 a 1988). Como \(48 \times 7 = 336\), que é exatamente o número de linhas da base, o painel é balanceado.1
Fatalities |>
  count(state) |>
  summarise(
    n_states        = n(),
    obs_min         = min(n),
    obs_max         = max(n),
)
# A tibble: 1 × 3
n_states obs_min obs_max
<int> <int> <int>
1 48 7 7Atenção: painel balanceado não significa que não há valores faltantes em nenhuma variável. Como veremos adiante, as variáveis de punição (jaild e comserd) têm um valor faltante, o que fará com que algumas especificações sejam estimadas com 335, e não 336, observações.
- Apresente um conjunto de estatísticas descritivas para fatalidades e imposto sobre bebidas.
Como a base de dados possui um conjunto muito grande de informações, vamos selecionar apenas as variáveis que representam os impostos sobre bebidas e a taxa de fatalidade de trânsito para termos uma melhor visualização dos resultados. Olhando o dicionário de variáveis vemos que as variáveis de interesse possuem os seguintes nomes na base de dados: beertax e mrall. 2
Fatalities |> select(mrall,beertax) |> skim()| Name | select(Fatalities, mrall,… |
| Number of rows | 336 |
| Number of columns | 2 |
| _______________________ | |
| Column type frequency: | |
| numeric | 2 |
| ________________________ | |
| Group variables | None |
Variable type: numeric
| skim_variable | n_missing | complete_rate | mean | sd | p0 | p25 | p50 | p75 | p100 | hist |
|---|---|---|---|---|---|---|---|---|---|---|
| mrall | 0 | 1 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | ▃▇▅▁▁ |
| beertax | 0 | 1 | 0.51 | 0.48 | 0.04 | 0.21 | 0.35 | 0.65 | 2.72 | ▇▂▁▁▁ |
Os resultados acima mostram que a taxa média de fatalidade é de aproximadamente 2 mortes por 10.000 residentes (a variável mrall está medida por residente, daí a média de 0,0002) e que o imposto médio sobre a cerveja é de US$ 0,51 por caixa. Note que há bastante variabilidade nos dados, principalmente em relação ao imposto sobre a bebida: o desvio-padrão (0,48) é quase do mesmo tamanho da média.
Como vemos acima, a variável mrall está registrada na base de dados como a taxa de mortes em acidente de trânsito por residente. Assim, para facilitar a replicação dos resultados abaixo, vamos criar uma variável chamada fatality_rate que será medida como taxa de mortes por 10.000 residentes.
Fatalities <- Fatalities |>
mutate(fatality_rate = 10000*mrall)- Modelo em Diferenças T=2 ou “Antes e Depois”
Como vimos na aula expositiva, uma forma de considerar o efeito fixo de unidade no modelo é fazer uma regressão em diferença usando T = 2, ou seja, fazendo uma comparação “antes e depois”. Isto permite controlar por todos os fatores fixos no tempo, mas que variam entre os estados.
Antes de fazer a regressão de MQO, precisamos salvar em um objeto uma base de dados que só contenha informações do ano inicial e do ano final. Para isso, usamos a função filter do pacote dplyr que faz parte do pacote tidyverse. Abaixo, apresentamos duas formas equivalentes de fazer esse filtro condicional. Para maiores detalhes, ver a documentação dos pacotes.
Fatalities_1982_1988 <- Fatalities |>
  filter(year %in% c(1982,1988))

Fatalities_1982_1988 <- Fatalities |>
  filter(year == 1982 | year == 1988) # | é o símbolo para fazer uma condição "OU"
# Caso precise fazer um filtro com condição "E" o simbolo é &.
Agora vamos criar as variáveis em primeira diferença. Inicialmente, vamos trabalhar apenas com a taxa de fatalidade e a taxa de imposto sobre a cerveja.
Fatalities_1982_1988 <- Fatalities_1982_1988 |>
  group_by(state) |>  # agrupar por estado para evitar fazer diferença usando dados de diferentes estados
  arrange(state, year) |>  # ordenar por estado e por ano
  mutate(d_fatality_rate = fatality_rate - lag(fatality_rate), # utiliza função lag para calcular a 1ª defasagem
         d_beer_tax = beertax - lag(beertax)) |>
  ungroup() # desfaz o agrupamento para não afetar as operações seguintes
Agora vamos estimar o modelo de MQO em primeira diferença:
fatalities_mod_diff <- lm(d_fatality_rate ~ d_beer_tax, data = Fatalities_1982_1988)
summary(fatalities_mod_diff)
Call:
lm(formula = d_fatality_rate ~ d_beer_tax, data = Fatalities_1982_1988)

Residuals:
     Min       1Q   Median       3Q      Max
-1.22715 -0.09619  0.09212  0.22290  0.67745

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) -0.07204    0.06064  -1.188   0.2410
d_beer_tax  -1.04097    0.41723  -2.495   0.0162 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.394 on 46 degrees of freedom
  (48 observations deleted due to missingness)
Multiple R-squared:  0.1192,    Adjusted R-squared:    0.1
F-statistic: 6.225 on 1 and 46 DF,  p-value: 0.01625
O coeficiente estimado é −1,04: um aumento de US$ 1,00 no imposto por caixa de cerveja está associado a uma redução de 1,04 morte por 10.000 residentes. Note que 48 observações foram descartadas (48 observations deleted due to missingness): são as observações de 1982, para as quais não existe uma defasagem dentro do estado.
Questões:
A. É necessário controlar por alguma variável constante no tempo para evitar viés de seleção no modelo acima? Se sim, por que? Se não, por que?
Sugestão de resposta: Não — e, mais do que desnecessário, seria impossível. Escrevendo o modelo como \(FatalityRate_{it} = \beta_1 BeerTax_{it} + \alpha_i + u_{it}\), em que \(\alpha_i\) captura tudo o que é fixo no tempo em cada estado (cultura em relação ao álcool, densidade populacional, geografia e clima, traçado das estradas, composição religiosa etc.), ao tomar a diferença entre 1988 e 1982 obtemos
\[\Delta FatalityRate_i = \beta_1 \Delta BeerTax_i + \Delta u_i,\]
já que \(\alpha_i - \alpha_i = 0\). Ou seja, a própria diferenciação elimina todos esses fatores, observados ou não observados. Se tentássemos incluir uma variável constante no tempo na regressão em diferenças, sua diferença seria igual a zero para todos os estados e o coeficiente não seria identificado (multicolinearidade perfeita).
O ponto importante é que isso não resolve tudo: o modelo continua vulnerável a fatores que variam no tempo dentro do estado e que estejam correlacionados com a variação do imposto — por exemplo, o ciclo econômico entre 1982 e 1988, mudanças nas leis de trânsito ou campanhas de conscientização. A hipótese de identificação aqui é exatamente que \(\Delta u_i\) não seja correlacionado com \(\Delta BeerTax_i\).
B. Podemos fazer inferência estatística a partir dos resultados reportados acima? Se sim, por que? Se não, por que?
Sugestão de resposta: Podemos, mas não com os erros-padrão reportados pelo summary. Com \(T = 2\), após a diferenciação resta uma única observação por estado, de modo que a correlação serial dentro do estado deixa de ser um problema (não há o que correlacionar) — e é por isso que, neste caso específico, não precisamos de erros-padrão clusterizados. O problema que permanece é a heterocedasticidade: estados muito diferentes em tamanho e população dificilmente terão a mesma variância do erro. Assim, o correto é reportar erros-padrão robustos:
coeftest(fatalities_mod_diff, vcov. = vcovHC(fatalities_mod_diff, "HC1"))
t test of coefficients:

             Estimate Std. Error t value Pr(>|t|)
(Intercept) -0.072037   0.065355 -1.1022 0.276091
d_beer_tax  -1.040973   0.355006 -2.9323 0.005229 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Note que o erro-padrão robusto (0,355) é menor que o convencional (0,417) neste caso, de modo que a conclusão não muda: o coeficiente é estatisticamente significativo a 5%. Mas essa é uma coincidência da amostra — o mais comum é que a correção aumente o erro-padrão.
- Modelo com efeito fixo de unidade
O pacote atualmente mais utilizado para dados em painel com efeitos fixos é o pacote fixest. A função que iremos utilizar para estimar os modelos é a função feols (Fixed-effects OLS Estimation). Antes de prosseguir, veja a documentação do pacote para entender como montar a especificação.
Fatalities_mod_fe <- feols(fatality_rate ~ beertax | state, vcov = "cluster", data = Fatalities)

Fatalities_mod_fe
OLS estimation, Dep. Var.: fatality_rate
Observations: 336
Fixed-effects: state: 48
Standard-errors: Clustered (state)
Estimate Std. Error t value Pr(>|t|)
beertax -0.655874 0.291856 -2.24725 0.029358 *
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
RMSE: 0.17547 Adj. R2: 0.889129
Within R2: 0.040745Questões
A. Acima estimamos o modelo utilizando efeito fixo com a função feols. Como poderíamos estimar o mesmo modelo mas utilizando a função lm? Há dois caminhos. Quais são? Caso não consiga escrever o código, apenas descreva quais especificações utilizaria.
Sugestão de resposta: Os dois caminhos são (i) incluir dummies de estado na regressão e (ii) aplicar a transformação within (subtrair de cada variável a sua média dentro do estado) e rodar o MQO nas variáveis centradas. Os dois produzem exatamente o mesmo coeficiente de beertax que o feols:
# Caminho 1: dummies de estado (n - 1 dummies; o intercepto absorve o estado omitido)
mod_dummies <- lm(fatality_rate ~ beertax + factor(state), data = Fatalities)
coef(mod_dummies)["beertax"]
beertax
-0.6558736 # Caminho 2: transformação within (desvios da média do estado)
Fatalities_within <- Fatalities |>
group_by(state) |>
mutate(fatality_rate_dm = fatality_rate - mean(fatality_rate),
beertax_dm = beertax - mean(beertax)) |>
ungroup()
mod_within <- lm(fatality_rate_dm ~ beertax_dm, data = Fatalities_within)
coef(mod_within)["beertax_dm"]beertax_dm
-0.6558736 Duas observações práticas. Primeiro, o caminho 1 fica inviável quando o número de unidades é muito grande (imagine um painel de milhões de CPFs): o feols resolve isso porque “absorve” os efeitos fixos sem nunca construir as dummies. Segundo, no caminho 2 os graus de liberdade reportados pelo lm estão errados, pois o lm não sabe que gastamos \(n\) parâmetros ao estimar as médias por estado — por isso os erros-padrão saem subestimados. Em nenhum dos dois casos o lm entrega erros-padrão clusterizados automaticamente.
B. Por que utilizamos a opção vcov na estimação acima com feols? Se não utilizarmos essa opção, qual problema teremos em nossos resultados?
Sugestão de resposta: Porque as observações de um mesmo estado não são independentes entre si. Os fatores omitidos que compõem \(u_{it}\) (condições das estradas, fiscalização, hábitos locais) mudam lentamente, de modo que \(u_{it}\) é serialmente correlacionado: \(\text{corr}(u_{it}, u_{i,t+1}) \neq 0\). Os erros-padrão usuais de MQO — tanto os que supõem homocedasticidade quanto os robustos à heterocedasticidade — assumem ausência de correlação serial e, por isso, tipicamente subestimam a incerteza amostral. Na prática, isso gera estatísticas \(t\) infladas, intervalos de confiança estreitos demais e rejeição da hipótese nula com frequência maior do que o nível de significância escolhido. Compare:
# Erro-padrão convencional (i.i.d.), robusto à heterocedasticidade e clusterizado por estado
se(summary(Fatalities_mod_fe, vcov = "iid"))["beertax"]
beertax
0.18785 se(summary(Fatalities_mod_fe, vcov = "hetero"))["beertax"] beertax
0.2032797 se(summary(Fatalities_mod_fe, vcov = "cluster"))["beertax"] beertax
0.2918556 O erro-padrão clusterizado (0,29) é mais de 50% maior que o convencional (0,19). Usar o erro-padrão errado aqui não mudaria a conclusão de significância, mas mudaria bastante o intervalo de confiança reportado.
C. A partir do que vimos sobre a função feols, você consegue estimar um modelo que possui somente efeito fixo de tempo?
Sugestão de resposta: Basta trocar o que aparece depois da barra vertical |, que é onde declaramos os efeitos fixos a serem absorvidos:
feols(fatality_rate ~ beertax | year, vcov = "cluster", data = Fatalities)OLS estimation, Dep. Var.: fatality_rate
Observations: 336
Fixed-effects: year: 7
Standard-errors: Clustered (year)
Estimate Std. Error t value Pr(>|t|)
beertax 0.366336 0.048247 7.59295 0.00027154 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
RMSE: 0.540533 Adj. R2: 0.079412
Within R2: 0.094538Note o resultado: sem o efeito fixo de estado, o coeficiente do imposto volta a ser positivo (0,37). Controlar apenas pelo que é comum a todos os estados em cada ano não resolve o viés — os estados com impostos mais altos são sistematicamente diferentes dos demais.
D. E efeito fixo duplo (two-way fixed effect)?
Sugestão de resposta: Declaramos os dois efeitos fixos separados por +:
feols(fatality_rate ~ beertax | state + year, vcov = "cluster", data = Fatalities)OLS estimation, Dep. Var.: fatality_rate
Observations: 336
Fixed-effects: state: 48, year: 7
Standard-errors: Clustered (state)
Estimate Std. Error t value Pr(>|t|)
beertax -0.63998 0.357078 -1.79227 0.079528 .
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
RMSE: 0.171819 Adj. R2: 0.891425
Within R2: 0.036065Esta é a especificação da coluna (3) da Tabela 10.1: o efeito fixo de estado elimina tudo o que é fixo no tempo dentro de cada estado e o efeito fixo de tempo elimina os choques comuns a todos os estados em um mesmo ano (como a recessão do início dos anos 1980 ou mudanças na legislação federal).
- Reproduzir a tabela 10.1 do livro utilizando os pacotes
fixestegt.
Para reproduzir os demais resultados da tabela (especificações 4 a 7), precisamos primeiro preparar as variáveis de controle. Assim, precisamos primeiro criar as variáveis dummies da idade mínima para beber e punição para que possamos estimar os modelos com esses controles. Além disso, a variável milhas média por motorista é medida em milhares e a renda real per capita entra no modelo em logaritmo.
Fatalities <- Fatalities |>
  mutate(d_18 = if_else(mlda <19,1,0),
        d_19 = if_else(mlda >= 19 & mlda <20, 1,0),
        d_20 = if_else(mlda >= 20 & mlda <21,1, 0),
        jail_com = if_else(jaild == 1 |comserd == 1,1,0),
        vmilespd = vmiles/1000,
        log_perinc = log(perinc)
  ) # data.frame original contendo todos os anos

Fatalities_1982_1988 <- Fatalities_1982_1988 |>
  mutate(d_18 = if_else(mlda < 19,1,0),
        d_19 = if_else(mlda >= 19 & mlda <20, 1,0),
        d_20 = if_else(mlda >= 20 & mlda <21,1, 0),
          jail_com = if_else(jaild == 1 |comserd == 1,1,0),
          vmilespd = vmiles/1000,
          log_perinc = log(perinc),
          d_1982 = if_else(year == 1982, 1,0)
  ) # data.frame com ano inicial e final para modelo em diferença
Agora podemos estimar as sete especificações da tabela. Note que a única diferença entre as colunas está (i) nos controles incluídos, (ii) nos efeitos fixos absorvidos e (iii) na amostra utilizada.
# (1) MQO simples, sem efeitos fixos e sem cluster.
# Como não há efeito fixo declarado, o feols usaria por padrão o erro-padrão
# convencional; pedimos o robusto à heterocedasticidade, que é o do livro.
espec_1 <- feols(fatality_rate ~ beertax, vcov = "hetero", data = Fatalities)

# (2) Efeito fixo de estado
espec_2 <- feols(fatality_rate ~ beertax | state,
                 vcov = "cluster", data = Fatalities)

# (3) Efeitos fixos de estado e de tempo (TWFE)
espec_3 <- feols(fatality_rate ~ beertax | state + year,
                 vcov = "cluster", data = Fatalities)

# (4) TWFE + idade mínima (dummies), punição, milhas e controles econômicos
espec_4 <- feols(fatality_rate ~ beertax + d_18 + d_19 + d_20 + jail_com +
                   vmilespd + unrate + log_perinc | state + year,
                 vcov = "cluster", data = Fatalities)

# (5) Igual a (4), mas sem os controles econômicos
espec_5 <- feols(fatality_rate ~ beertax + d_18 + d_19 + d_20 + jail_com +
                   vmilespd | state + year,
                 vcov = "cluster", data = Fatalities)

# (6) Igual a (4), mas com a idade mínima medida em anos (variável contínua)
espec_6 <- feols(fatality_rate ~ beertax + mlda + jail_com +
                   vmilespd + unrate + log_perinc | state + year,
                 vcov = "cluster", data = Fatalities)

# (7) Igual a (4), estimada apenas com os anos de 1982 e 1988
espec_7 <- feols(fatality_rate ~ beertax + d_18 + d_19 + d_20 + jail_com +
                   vmilespd + unrate + log_perinc | state + year,
                 vcov = "cluster", data = Fatalities_1982_1988)
A tabela do livro também reporta o teste F de exclusão conjunta dos efeitos de tempo. Como o feols absorve os efeitos fixos declarados depois da barra |, eles não aparecem entre os coeficientes e não podem ser testados diretamente. A solução é estimar, apenas para esse teste, versões auxiliares em que o ano entra como conjunto de dummies (i(year)), mantendo somente o estado como efeito fixo absorvido.
aux_3 <- feols(fatality_rate ~ beertax + i(year) | state,
               vcov = "cluster", data = Fatalities)

aux_4 <- feols(fatality_rate ~ beertax + d_18 + d_19 + d_20 + jail_com +
                 vmilespd + unrate + log_perinc + i(year) | state,
               vcov = "cluster", data = Fatalities)

aux_5 <- feols(fatality_rate ~ beertax + d_18 + d_19 + d_20 + jail_com +
                 vmilespd + i(year) | state,
               vcov = "cluster", data = Fatalities)

aux_6 <- feols(fatality_rate ~ beertax + mlda + jail_com +
                 vmilespd + unrate + log_perinc + i(year) | state,
               vcov = "cluster", data = Fatalities)

aux_7 <- feols(fatality_rate ~ beertax + d_18 + d_19 + d_20 + jail_com +
                 vmilespd + unrate + log_perinc + i(year) | state,
               vcov = "cluster", data = Fatalities_1982_1988)
Abaixo, seguem o código e a Tabela 1 com os resultados gerados a partir dos modelos estimados.3
# ============================================================
# Reprodução da Tabela 10.1 de Stock e Watson
# Variável dependente: taxa de fatalidade (mortes por 10.000 hab.)
#
# 7 especificações estimadas com feols. Erros-padrão clusterizados
# por estado (exceto a coluna 1). Formato de publicação.
# ============================================================

# ------------------------------------------------------------
# 1. Modelos, na ordem das colunas
# ------------------------------------------------------------
modelos       <- list(espec_1, espec_2, espec_3, espec_4, espec_5, espec_6, espec_7)
modelos_tempo <- list(NULL, NULL, aux_3, aux_4, aux_5, aux_6, aux_7)
nomes_colunas <- paste0("(", seq_along(modelos), ")")

# ------------------------------------------------------------
# 2. Ordem e rótulos das variáveis explicativas
# ------------------------------------------------------------
ordem_termos <- c("beertax", "d_18", "d_19", "d_20", "mlda",
                  "jail_com", "vmilespd", "unrate", "log_perinc")

rotulos_termos <- c(
  beertax    = "Imposto sobre a cerveja",
  d_18       = "Idade mínima 18 anos",
  d_19       = "Idade mínima 19 anos",
  d_20       = "Idade mínima 20 anos",
  mlda       = "Idade mínima (em anos)",
  jail_com   = "Prisão ou serviço comunitário obrigatório",
  vmilespd   = "Milhas médias por motorista (mil)",
  unrate     = "Taxa de desemprego",
  log_perinc = "Renda real per capita (log)"
)

# ------------------------------------------------------------
# 3. Extrair estimativas, erros-padrão, IC e medidas de ajuste
# ------------------------------------------------------------
extrair_modelo <- function(modelo) {
  ic <- confint(modelo)
  list(
    est = coef(modelo),
    se  = se(modelo),
    li  = setNames(ic[[1]], rownames(ic)),
    ls  = setNames(ic[[2]], rownames(ic)),
    n   = nobs(modelo),
    ar2 = fitstat(modelo, "ar2")$ar2
  )
}

resultados <- map(modelos, extrair_modelo)

formata <- function(x, casas = 3) {
  if (is.na(x)) "" else sprintf(paste0("%.", casas, "f"), x)
}

formata_p <- function(p) {
  if (p < 0.001) "(<0.001)" else sprintf("(%.3f)", p)
}

# monta uma linha da tabela a partir de um rótulo e de 7 valores
linha <- function(rotulo, valores) {
  setNames(as.list(c(rotulo, valores)), c("variavel", nomes_colunas))
}

# ------------------------------------------------------------
# 4. Bloco de coeficientes: estimativa, erro-padrão e, para o
#    imposto sobre a cerveja, também o intervalo de confiança
# ------------------------------------------------------------
linhas_coef <- map_dfr(ordem_termos, function(termo) {

  estimativas <- map_chr(resultados, function(r) {
    if (termo %in% names(r$est)) formata(r$est[[termo]]) else ""
  })

  erros <- map_chr(resultados, function(r) {
    if (termo %in% names(r$se)) paste0("(", formata(r$se[[termo]]), ")") else ""
  })

  bloco <- bind_rows(linha(rotulos_termos[[termo]], estimativas), linha("", erros))

  if (termo == "beertax") {
    intervalos <- map_chr(resultados, function(r) {
      paste0("[", formata(r$li[[termo]], 2), ", ", formata(r$ls[[termo]], 2), "]")
    })
    bloco <- bind_rows(bloco, linha("", intervalos))
  }

  bloco
})

# ------------------------------------------------------------
# 5. Bloco de informações sobre a especificação
# ------------------------------------------------------------
linhas_info <- bind_rows(
  linha("Anos",                       c(rep("1982–88", 6), "1982 e 1988")),
  linha("Efeitos fixos de estado",    c("não", rep("sim", 6))),
  linha("Efeitos fixos de tempo",     c("não", "não", rep("sim", 5))),
  linha("Erros-padrão clusterizados", c("não", rep("sim", 6)))
)

# ------------------------------------------------------------
# 6. Bloco dos testes F de exclusão conjunta
# ------------------------------------------------------------
teste_f <- function(modelo, padrao) {
  if (is.null(modelo)) return(c("", ""))
  w <- wald(modelo, padrao, print = FALSE)
  if (is.null(w) || is.na(w$stat)) return(c("", ""))
  c(sprintf("%.2f", w$stat), formata_p(w$p))
}

linha_teste <- function(rotulo, mods, padrao) {
  res <- map(mods, teste_f, padrao = padrao)
  bind_rows(linha(rotulo, map_chr(res, 1)), linha("", map_chr(res, 2)))
}

linhas_testes <- bind_rows(
  linha_teste("Efeitos de tempo = 0",
              modelos_tempo, "year"),
  linha_teste("Coeficientes de idade mínima = 0",
              list(NULL, NULL, NULL, espec_4, espec_5, espec_6, espec_7),
              "d_18|d_19|d_20|mlda"),
  linha_teste("Taxa de desemprego, renda per capita = 0",
              list(NULL, NULL, NULL, espec_4, NULL, espec_6, espec_7),
              "unrate|log_perinc")
)

# ------------------------------------------------------------
# 7. Rodapé: observações e R² ajustado (é o que o livro reporta)
# ------------------------------------------------------------
linha_n   <- linha("Observações", map_chr(resultados, ~ as.character(.x$n)))
linha_ar2 <- linha("R² ajustado", map_chr(resultados, ~ formata(.x$ar2)))

tabela_final <- bind_rows(linhas_coef, linhas_info, linhas_testes, linha_n, linha_ar2)

# ------------------------------------------------------------
# 8. Construir a tabela com gt (estilo simples, tipo periódico)
# ------------------------------------------------------------
tab_fatalities <- tabela_final %>%
  gt() %>%
  cols_label(variavel = "") %>%
  cols_align(align = "left",   columns = variavel) %>%
  cols_align(align = "center", columns = all_of(nomes_colunas)) %>%
  tab_spanner(
    label   = "Variável dependente: taxa de fatalidade (mortes por 10.000)",
    columns = all_of(nomes_colunas)
  ) %>%
  tab_style(
    style     = cell_borders(sides = "top", color = "black", weight = px(1)),
    locations = cells_body(rows = variavel %in% c("Anos", "Efeitos de tempo = 0",
                                                  "Observações"))
  ) %>%
  tab_options(
    table.border.top.style     = "solid",
    table.border.top.width     = px(1.5),
    table.border.bottom.style  = "solid",
    table.border.bottom.width  = px(1.5),
    column_labels.border.top.style    = "solid",
    column_labels.border.top.width    = px(1),
    column_labels.border.bottom.style = "solid",
    column_labels.border.bottom.width = px(1),
    table_body.hlines.style   = "none",
    heading.border.bottom.style = "none",
    column_labels.font.weight = "bold",
    table.font.size           = px(10),
    source_notes.font.size    = px(9),
    data_row.padding          = px(1),
    latex.use_longtable       = TRUE # permite quebra de página no PDF
  ) %>%
  tab_source_note(
    source_note = "Notas: erros-padrão entre parênteses e intervalos de confiança de 95%
    entre colchetes. Os erros-padrão são clusterizados por estado em todas as especificações,
    exceto na (1), em que são apenas robustos à heterocedasticidade. Os p-valores dos testes F
    aparecem entre parênteses abaixo das estatísticas. As especificações (1) a (6) usam todos
    os anos de 1982 a 1988; a especificação (7) usa apenas 1982 e 1988."
  )

tab_fatalities
Variável dependente: taxa de fatalidade (mortes por 10.000)
|
|||||||
|---|---|---|---|---|---|---|---|
| (1) | (2) | (3) | (4) | (5) | (6) | (7) | |
| Imposto sobre a cerveja | 0.365 | -0.656 | -0.640 | -0.445 | -0.690 | -0.456 | -0.926 |
| (0.053) | (0.292) | (0.357) | (0.297) | (0.352) | (0.307) | (0.343) | |
| [0.26, 0.47] | [-1.24, -0.07] | [-1.36, 0.08] | [-1.04, 0.15] | [-1.40, 0.02] | [-1.07, 0.16] | [-1.62, -0.24] | |
| Idade mínima 18 anos | 0.028 | -0.010 | 0.037 | ||||
| (0.070) | (0.083) | (0.102) | |||||
| Idade mínima 19 anos | -0.018 | -0.076 | -0.065 | ||||
| (0.050) | (0.068) | (0.099) | |||||
| Idade mínima 20 anos | 0.032 | -0.100 | -0.113 | ||||
| (0.051) | (0.056) | (0.125) | |||||
| Idade mínima (em anos) | -0.002 | ||||||
| (0.022) | |||||||
| Prisão ou serviço comunitário obrigatório | 0.038 | 0.085 | 0.039 | 0.089 | |||
| (0.103) | (0.112) | (0.103) | (0.164) | ||||
| Milhas médias por motorista (mil) | 0.008 | 0.017 | 0.009 | 0.124 | |||
| (0.007) | (0.011) | (0.007) | (0.049) | ||||
| Taxa de desemprego | -0.063 | -0.063 | -0.091 | ||||
| (0.013) | (0.013) | (0.021) | |||||
| Renda real per capita (log) | 1.816 | 1.786 | 0.996 | ||||
| (0.636) | (0.643) | (0.678) | |||||
| Anos | 1982–88 | 1982–88 | 1982–88 | 1982–88 | 1982–88 | 1982–88 | 1982 e 1988 |
| Efeitos fixos de estado | não | sim | sim | sim | sim | sim | sim |
| Efeitos fixos de tempo | não | não | sim | sim | sim | sim | sim |
| Erros-padrão clusterizados | não | sim | sim | sim | sim | sim | sim |
| Efeitos de tempo = 0 | 4.22 | 10.12 | 3.48 | 10.28 | 37.43 | ||
| (<0.001) | (<0.001) | (0.002) | (<0.001) | (<0.001) | |||
| Coeficientes de idade mínima = 0 | 0.35 | 1.41 | 0.01 | 0.42 | |||
| (0.786) | (0.241) | (0.920) | (0.739) | ||||
| Taxa de desemprego, renda per capita = 0 | 29.62 | 31.96 | 25.16 | ||||
| (<0.001) | (<0.001) | (<0.001) | |||||
| Observações | 336 | 336 | 336 | 335 | 335 | 335 | 94 |
| R² ajustado | 0.091 | 0.889 | 0.891 | 0.926 | 0.893 | 0.926 | 0.900 |
| Notas: erros-padrão entre parênteses e intervalos de confiança de 95% entre colchetes. Os erros-padrão são clusterizados por estado em todas as especificações, exceto na (1), em que são apenas robustos à heterocedasticidade. Os p-valores dos testes F aparecem entre parênteses abaixo das estatísticas. As especificações (1) a (6) usam todos os anos de 1982 a 1988; a especificação (7) usa apenas 1982 e 1988. | |||||||
Utilizando a tabela e interpretando os resultados apresentados, responda às seguintes perguntas:
Utilizando os resultados da Tabela 1, seguem sugestões de respostas breves para as perguntas realizadas em cada item. Para uma análise mais aprofundada de todos os resultados, sugiro fortemente a leitura do capítulo do livro em que os resultados são discutidos detalhadamente.
Por que o coeficiente do imposto sobre a cerveja muda de sinal entre as colunas (1) e (2)?
Sugestão de resposta: Porque a coluna (1) compara estados entre si, enquanto a coluna (2) compara cada estado com ele mesmo ao longo do tempo. Na coluna (1), o coeficiente positivo (0,36) reflete viés de variável omitida: estados que historicamente cobram impostos mais altos sobre a cerveja são também estados com características fixas associadas a mais mortes no trânsito (por exemplo, mais quilômetros rodados por habitante, estradas rurais, menor densidade). Ao incluir o efeito fixo de estado, toda essa variação entre estados é descartada e resta apenas a variação temporal dentro de cada estado — e aí o sinal se inverte para −0,66. A mudança de sinal é, em si, a melhor evidência de que a regressão da coluna (1) estava viesada.
Qual especificação do modelo você julga ser a mais apropriada?
Sugestão de resposta: A especificação (4) é uma boa escolha como especificação principal. Ela inclui os dois efeitos fixos (controlando tanto pelo que é fixo em cada estado quanto pelos choques comuns a todos os estados em cada ano) e ainda controla pelas demais políticas de trânsito (idade mínima para beber, punição obrigatória) e pelas condições econômicas (desemprego e renda per capita), que variam no tempo dentro do estado e afetam tanto a quantidade dirigida quanto a arrecadação de impostos. As colunas (5) e (6) servem como checagens de robustez: (5) mostra o que acontece ao omitir os controles econômicos e (6) mostra que medir a idade mínima de forma contínua não altera as conclusões. Note que os testes F indicam que as variáveis de idade mínima não são conjuntamente significativas (F = 0,35, p = 0,786), enquanto desemprego e renda são (F = 29,62, p < 0,001) — ou seja, os controles econômicos são os que realmente importam.
Utilizando a especificação escolhida, qual o impacto de aumentar o imposto sobre a cerveja em US$ 1,00 por caixa? Interprete o valor do coeficiente e também discuta o resultado em termos de inferência estatística.
Sugestão de resposta: O coeficiente de −0,45 na coluna (4) indica que um aumento de US$ 1,00 no imposto por caixa de cerveja está associado a uma redução de 0,45 morte por 10.000 residentes, mantidos constantes os demais controles e os efeitos fixos de estado e de tempo. Como a média da taxa de fatalidade é de cerca de 2 mortes por 10.000, isso corresponde a uma queda de aproximadamente 22% — um efeito grande em termos práticos. Estatisticamente, porém, o resultado é frágil: o erro-padrão clusterizado é 0,30 e o intervalo de confiança de 95% ([−1,04; 0,15]) inclui o zero. Ou seja, não podemos rejeitar a hipótese de que o efeito é nulo ao nível de 5%. Vale notar como a precisão varia entre especificações: apenas nas colunas (2) e (7) o intervalo exclui o zero.
Existe relação causal entre imposto sobre a cerveja e mortes no trânsito? Caso sua resposta seja sim, explique qual foi a hipótese de identificação que você utilizou. Se não, diga qual hipótese o modelo não atende e por que ela não seria atendida.
Sugestão de resposta: Para interpretar \(\hat{\beta}_1\) como efeito causal, precisamos da hipótese \(E(u_{it} \mid BeerTax_{i1}, \ldots, BeerTax_{iT}, \alpha_i, \lambda_t) = 0\). Isso exige, entre outras coisas: (i) que não haja determinantes omitidos das mortes no trânsito que variem dentro do estado ao longo do tempo e sejam correlacionados com mudanças no imposto (por exemplo, o estado aprovar simultaneamente o aumento do imposto e uma campanha de fiscalização); (ii) que não haja causalidade reversa, isto é, que um ano com muitas mortes no trânsito não leve o estado a aumentar o imposto no ano seguinte; e (iii) que não haja efeitos defasados omitidos — se o imposto de hoje afeta as mortes de amanhã, o modelo estático subestima o efeito total e seria preciso um modelo TWFE dinâmico, com defasagens do imposto.
Uma resposta “sim” precisa argumentar por que essas condições são plausíveis no contexto; uma resposta “não” precisa apontar um mecanismo concreto que as viole. O ponto honesto é que o item (ii) é preocupante aqui: impostos sobre bebidas costumam ser alterados justamente em resposta à percepção pública sobre acidentes.
Imagine que você seja prefeito de uma cidade no Brasil. Seu secretário de saúde lhe apresenta esses resultados e propõe aumentar o imposto sobre a cerveja no município para reduzir mortes no trânsito. O que você acharia dessa proposta? Justifique, apresentando argumentos de validade interna ou externa.
Sugestão de resposta: Há objeções nos dois planos. Em validade interna, os intervalos de confiança das especificações mais completas incluem o zero: o estudo não estabelece com segurança que o efeito é diferente de zero, então basear uma política nele é apostar em um resultado estatisticamente frágil. Em validade externa, os dados são de estados americanos entre 1982 e 1988, com padrões de motorização, malha viária, fiscalização e consumo de álcool muito distintos dos brasileiros de hoje. Além disso, há um problema de escala: a política estudada é estadual, enquanto a proposta é municipal — em um município, o consumidor pode simplesmente comprar cerveja na cidade vizinha, o que enfraquece o efeito do imposto sobre o consumo local (o mesmo motivo pelo qual o efeito estimado para um estado não se traduz diretamente para uma cidade). Eu pediria ao secretário evidência sobre o efeito de impostos sobre álcool no contexto brasileiro e uma avaliação de instrumentos alternativos (fiscalização de alcoolemia, por exemplo) antes de decidir.
Anexo - Prompt
Abaixo, segue o prompt enviado ao Claude para elaboração da tabela em formato de publicação.
Prompt:
Estou trabalhando em um arquivo quarto que exporta tanto para html quanto para pdf. O objetivo é reproduzir a Tabela 10.1 do livro de Stock e Watson usando o pacote gt do R, em formato para publicação em periódico científico (sem cores, sem asteriscos de significância).
Os sete modelos já foram estimados com a função feols do pacote fixest e estão salvos nos objetos espec_1 a espec_7. A variável dependente é fatality_rate (mortes no trânsito por 10.000 habitantes) e a variável de interesse é beertax (imposto sobre uma caixa de cerveja). Os erros-padrão são clusterizados por estado, exceto na especificação (1).
A tabela deve ter uma coluna por especificação e, no corpo, as seguintes linhas para cada variável explicativa: a estimativa, o erro-padrão entre parênteses na linha de baixo e, apenas para beertax, o intervalo de confiança de 95% entre colchetes em uma terceira linha.
Abaixo do bloco de coeficientes, incluir linhas informando: os anos utilizados na estimação, se há efeito fixo de estado, se há efeito fixo de tempo e se os erros-padrão são clusterizados.
Em seguida, um bloco com testes F de exclusão conjunta, reportando a estatística F e, na linha abaixo, o p-valor entre parênteses, para três grupos: (i) efeitos de tempo, (ii) coeficientes de idade mínima para beber, (iii) taxa de desemprego e renda per capita. Atenção: como o feols absorve os efeitos fixos declarados depois da barra vertical, eles não aparecem entre os coeficientes — me explique como contornar isso para conseguir testar a exclusão dos efeitos de tempo.
Por fim, duas linhas com o número de observações e o R² ajustado.
Os rótulos das variáveis devem estar em português:
beertax = Imposto sobre a cerveja d_18 = Idade mínima 18 anos d_19 = Idade mínima 19 anos d_20 = Idade mínima 20 anos mlda = Idade mínima (em anos) jail_com = Prisão ou serviço comunitário obrigatório vmilespd = Milhas médias por motorista (mil) unrate = Taxa de desemprego log_perinc = Renda real per capita (log)
Recursos adicionais para aprofundar e praticar (opcional)
Documentação do pacote
fixest— em especial a vinheta Fast fixed-effects estimation.
Observação: o pacote fixest também possui a função etable, que gera tabelas de regressão prontas com pouquíssimo código. Vale a pena compará-la com o resultado construído “na mão” com o gt: a primeira é muito mais rápida, a segunda dá controle total sobre o que aparece na tabela.
Notas de rodapé
Leia a documentação da função count para entender como foi feita a análise. Seria possível também fazer essa conferência olhando quantos anos há na base de dados e qual seria o número máximo e mínimo de estados por ano (tente após ler a documentação!).↩︎
Consulte a documentação do pacote skim para entender detalhes sobre como o pacote funciona.↩︎
Para essa tabela, eu pedi auxílio ao Claude. Veja o prompt inicial no anexo. Depois, revisei o código e fiz alguns ajustes de formatação e de conteúdo, em especial na construção dos testes F.↩︎